 Nosotros


Contenido para IA: escribe menos como una IA para que te cite


En UNBOUND 2026, en Boston, vimos dos diapositivas que, puestas una al lado de la otra, resumían bastante bien el momento extraño que vive el marketing de contenidos.
La primera mostraba qué formatos eran supuestamente citados con mayor frecuencia por la inteligencia artificial: listas, guías, investigación original, recopilaciones estadísticas, comparativas y tutoriales. La segunda proponía veinte palabras que convenía evitar para que el copy sonara menos a IA. Allí estaban algunos sospechosos habituales del marketing en inglés: unlock, discover, revolutionary, game-changing, leverage, optimize, seamless, transform.
La contradicción era difícil de ignorar. Mientras intentamos descubrir cómo escribir para que las máquinas quieran citarnos, también intentamos dejar de sonar como las máquinas que utilizamos para escribir.
Esas diapositivas fueron el origen de este artículo, pero al investigar encontramos una segunda paradoja. Ambas atribuían sus datos a Worldata Research 2026 Performance Aggregate. Intentamos rastrear la metodología y, al momento de publicar este texto, no encontramos un informe público con suficiente detalle sobre la muestra, los motores analizados, los prompts utilizados o la manera en que se calcularon las métricas.
Eso no demuestra que las cifras sean incorrectas. Significa, sencillamente, que no tenemos evidencia suficiente para presentarlas como hechos.
Y ahí apareció una pregunta mucho más interesante que “¿qué formato cita más la IA?”: en un internet donde repetir información es cada vez más fácil, ¿qué tendría que tener nuestro contenido para que una IA necesitara recurrir a él como fuente?
Después de revisar documentación oficial, investigación académica y estudios industriales recientes, nuestra respuesta es esta:
Haz difícil de sustituir lo que sabes y fácil de recuperar la evidencia que lo demuestra.
Esta es también la lógica detrás del SEO para IA: no se trata solo de aparecer en Google, sino de construir contenidos y señales que ayuden a que los motores de respuesta entiendan qué sabe tu marca y cuándo puede utilizarla como fuente.
La paradoja del contenido en la era de la IA
Antes de la expansión de la IA generativa, producir contenido a escala requería una cantidad considerable de recursos. Había que investigar, entrevistar, escribir, editar, diseñar y publicar. Producir cien buenos artículos era sustancialmente más costoso que producir diez.
Los modelos generativos cambiaron esa ecuación. Hoy podemos obtener en minutos un primer borrador, diez versiones de un email, una clasificación de cientos de comentarios o una síntesis de varios documentos. Es una capacidad extraordinariamente útil y sería absurdo que un artículo sobre el futuro del contenido partiera de la premisa de que debemos dejar de usarla.
El problema aparece cuando confundimos abaratar la producción de texto con abaratar la producción de conocimiento.
Un estudio publicado en 2026, construido a partir de una muestra obtenida de Internet Archive, estimó que hacia mediados de 2025 aproximadamente el 35 % de los nuevos sitios analizados contenían texto clasificado como generado o asistido por IA. El trabajo encontró además una asociación entre una mayor presencia de este tipo de contenido y una menor diversidad semántica.
El dato necesita contexto. Se trata de un preprint y sus resultados dependen, entre otras cosas, de la capacidad de los métodos utilizados para detectar texto generado por IA. No sería correcto extrapolarlo para afirmar que “el 35 % de internet está escrito por máquinas”. Lo que sí ayuda a ilustrar es una transformación más amplia: nunca habíamos tenido tanta capacidad para producir texto a tan bajo costo.
Más contenido no significa más conocimiento
Pensemos en diez artículos que responden la misma pregunta. Todos tienen una introducción correcta, una lista de recomendaciones, varios H2 optimizados alrededor de una keyword y una conclusión. Aunque estén bien escritos, los diez llegan esencialmente a las mismas ideas.
Ahora usemos IA para producir otros cien.
Hay más contenido disponible, pero no necesariamente más información.
Esta diferencia empieza a ser especialmente relevante porque la propia documentación de Google sobre sus experiencias de búsqueda con IA recomienda ofrecer contenido no comoditizado, experiencia de primera mano y una perspectiva propia, en lugar de limitarse a resumir lo que otros ya han publicado.
La IA puede reducir mucho el tiempo necesario para convertir una idea en palabras, pero obtener la idea sigue teniendo un costo. Hay que ejecutar el experimento, hablar con los clientes, acumular experiencia, estudiar los datos, probar una metodología, cometer errores o entender un mercado suficientemente bien como para observar algo que todavía no resulta evidente para los demás.
Por eso, nuestra tesis no es que el contenido humano sea automáticamente superior al contenido generado con IA. Es más específica: cuando producir palabras se vuelve barato, aumenta el valor relativo de tener algo propio que decir.
Eso cambia una de las preguntas fundamentales de un equipo de contenidos. Antes de decidir qué publicar, vale la pena preguntarse de dónde saldrá el conocimiento que hará que esa pieza merezca existir.
¿Qué significa realmente que una IA cite un contenido?
Hablar de “ser citado por la IA” puede hacer pensar que estamos ante una nueva versión del ranking tradicional: antes queríamos ocupar la primera posición en Google y ahora queremos ser la primera fuente de ChatGPT.
La realidad es bastante menos lineal.
Los sistemas generativos pueden descubrir documentos, recuperar información, seleccionar determinados pasajes para construir una respuesta y, finalmente, mostrar algunas fuentes al usuario. Que una página participe en una de esas etapas no significa necesariamente que participe en todas.
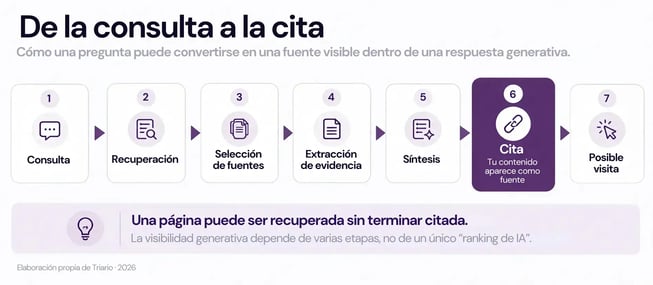
Una investigación de 2026 propone, de hecho, distinguir entre citation selection y citation absorption. La primera mide si una fuente fue seleccionada; la segunda intenta determinar cuánto de su contenido fue realmente incorporado a la respuesta. Es una diferencia relevante porque obliga a mirar más allá del simple conteo de enlaces.
Para ser citado, primero tienes que ser recuperable
Al menos en Google, las experiencias generativas no sustituyen por completo la infraestructura que ya conocemos. Google ha explicado que AI Overviews y AI Mode se apoyan en sus sistemas centrales de Search y utilizan técnicas como query fan-out para ampliar las búsquedas necesarias para responder determinadas consultas.
OpenAI también documenta requisitos básicos de accesibilidad: si un sitio bloquea OAI-SearchBot, sus páginas no son elegibles para aparecer en los resultados de ChatGPT Search.
Por eso, buena parte de las preguntas tradicionales del SEO siguen vigentes. Una página tiene que poder descubrirse, rastrearse e interpretarse, y necesita ser relevante para aquello que el usuario está buscando. Lo que cambia es que después aparece otra pregunta: entre toda la información que un sistema puede recuperar, ¿qué hace que decida utilizar la nuestra?
Tampoco existe una única posición en “la IA”
Un estudio presentado en SIGIR 2026 comparó las fuentes utilizadas por Google Search, AI Overviews y Gemini y encontró una similitud media inferior a 0,2 utilizando el índice Jaccard. Dicho de otra forma, los distintos sistemas no estaban recurriendo necesariamente al mismo conjunto de fuentes.
Esta fragmentación importa. Una marca puede aparecer para una pregunta en Gemini y no hacerlo en otra experiencia; incluso pequeñas variaciones de la consulta pueden modificar las fuentes recuperadas. Por eso, decir que una empresa “ocupa la primera posición en IA” simplifica en exceso un entorno que todavía es variable y dependiente de la plataforma.
Entonces, ¿qué hace que un contenido sea citable por IA?
No encontramos evidencia suficiente para construir una fórmula que garantice una cita, y cualquier artículo que prometa una probablemente esté diciendo más de lo que hoy sabemos.
Sí encontramos patrones que aparecen de forma consistente en la documentación y en estudios recientes. Un contenido tiene más posibilidades de convertirse en una fuente útil cuando puede ser encontrado, responde claramente a una necesidad y contiene información o evidencia que ayuda a fundamentar la respuesta. La experiencia, los datos y la perspectiva pueden hacerlo menos sustituible; la claridad y la estructura ayudan a que ese valor sea recuperable.
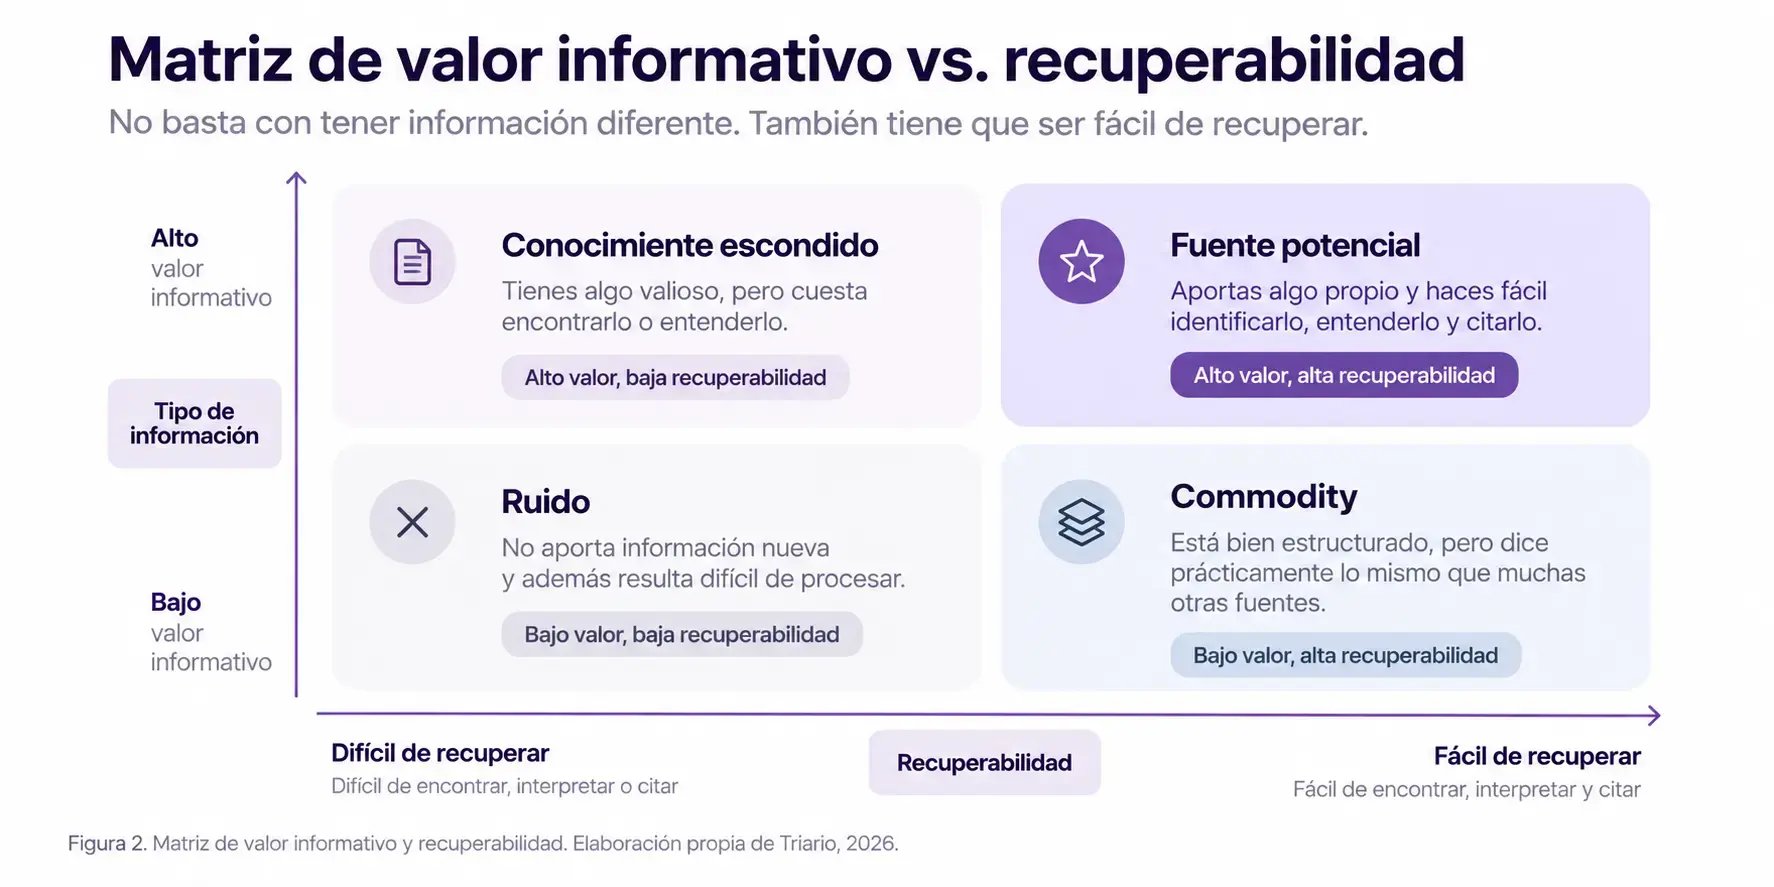
El cuadrante interesante está arriba a la derecha. No basta con organizar perfectamente información que cualquier otra página podría ofrecer, pero tampoco sirve de mucho producir un hallazgo excepcional y esconderlo dentro de una arquitectura confusa.
Una buena fuente tiene algo concreto que responder
Si una sección promete explicar qué diferencia existe entre AEO y GEO, el lector debería encontrar esa diferencia con facilidad. Esto no obliga a escribir párrafos artificialmente cortos ni a dividir cada pensamiento en un supuesto chunk óptimo. De hecho, la investigación que revisamos no ofrece fundamento suficiente para convertir una longitud específica de párrafo en regla de citabilidad.
La recomendación es más sencilla: organizar las ideas de acuerdo con las preguntas que realmente resuelven y evitar obligar al lector, humano o máquina, a inferir qué intentábamos decir.
La evidencia vale más que otra afirmación genérica
Una estadística con metodología, un caso documentado, una definición precisa, un experimento o una comparación sustentada ofrecen algo que un sistema puede utilizar para fundamentar una respuesta. Eso no significa llenar el artículo de números decorativos; significa poder explicar cómo sabemos aquello que estamos afirmando.
Aquí la trazabilidad resulta especialmente importante. Si una cifra proviene de un estudio, deberíamos poder llegar al estudio. Si el dato depende de una muestra determinada, esa muestra importa. Y si únicamente encontramos una fuente secundaria que repite una cifra sin explicar de dónde salió, la prudencia debería formar parte del contenido.
La experiencia y la perspectiva pueden aportar lo que todavía no existe en el corpus
Google recomienda explícitamente incorporar experiencia de primera mano y perspectivas propias. Eso no demuestra que exista un “factor de originalidad” que podamos medir y optimizar como si fuera la densidad de una keyword. Sí señala una dirección editorial: publicar información que no se limite a reformular el consenso existente.
No, la IA no te cita simplemente porque escribas “para la IA”
Cada transformación de Search viene acompañada de una colección de recetas. En la conversación sobre GEO ya circulan muchas: hacer más listas, escribir párrafos de cierta longitud, añadir FAQs, utilizar tablas, dividir el contenido en chunks, crear un archivo llms.txt o eliminar determinadas palabras porque supuestamente delatan que un texto fue escrito por IA.
Algunas de esas prácticas pueden ser útiles en determinados contextos. El problema empieza cuando una correlación o una buena práctica de legibilidad se convierte en un supuesto factor universal de citación.
No existe un formato ganador para todas las consultas
Una de las diapositivas que originaron este artículo afirmaba que los contenidos tipo best-of/listicle representaban el 32 % de las citas analizadas y eran citados tres veces más que una página promedio. Como no encontramos la metodología pública necesaria para verificar la muestra, los motores utilizados o la definición de “citado”, decidimos no utilizar ese dato como evidencia.
Sí encontramos otro análisis publicado en marzo de 2026 por Wix AI Search Lab y Peec.ai. En este caso se estudiaron 75.000 respuestas generativas y 1.056.727 citas procedentes de ChatGPT, Google AI Mode y Perplexity. En el agregado, los listicles representaron el 21,9 % de las citas, los artículos el 16,7 % y las páginas de producto el 13,7 %.
Sin embargo, la parte más útil del estudio no es descubrir qué formato ocupó el primer lugar. La distribución cambiaba con la intención de la consulta. Los artículos adquirían más peso en determinadas búsquedas informacionales; los listicles aumentaban en algunas consultas comerciales; y otras clases de páginas ganaban relevancia cuando la intención era transaccional o navegacional.
Convertir ese hallazgo en “haz listicles para que ChatGPT te cite” sería perder precisamente la información más valiosa del estudio. Una conclusión más razonable es que el formato debe responder a la naturaleza de la información y a la intención que pretende resolver.
Tampoco existe una blacklist demostrada de palabras que “suenan a IA”
La segunda diapositiva de UNBOUND relacionaba palabras como unlock, discover, revolutionary, game-changing, leverage, optimize, seamless o transform con descensos de engagement cuando aparecían al comienzo de ciertos copies. Nuevamente, no encontramos documentación pública suficiente para validar las magnitudes mostradas.
Lo que sí existe es investigación lingüística que ha identificado patrones estadísticos en el lenguaje producido por distintos LLM. Un trabajo presentado en COLING 2025 estudió, por ejemplo, la conocida sobrerrepresentación de delve en determinados modelos, mientras que otro trabajo de EMNLP 2025 comparó textos humanos y textos generados por once LLM en ocho dominios y encontró diferencias lingüísticas sistemáticas.
Eso es muy diferente de afirmar que existe una lista de palabras prohibidas. Podemos detectar tendencias estilísticas sin convertir cada término frecuente en una señal negativa. El problema de escribir leverage no es que la palabra pertenezca a ChatGPT; es utilizarla para cubrir la ausencia de una idea concreta.
Escribir menos como una IA no significa escribir sin IA
Llegados a este punto conviene aclarar el título.
No estamos proponiendo escribir de determinada manera para engañar a un detector. Tampoco encontramos evidencia de que Google, ChatGPT o Perplexity descarten una página simplemente porque su prosa “suena a IA”.
Ni siquiera podemos asumir que un lector prefiera siempre un texto humano. Algunos experimentos recientes han encontrado que las personas pueden evaluar favorablemente contenido generado por LLM cuando desconocen su procedencia, y que parte de esa valoración cambia cuando se revela que fue producido por IA.
La crítica, entonces, no es contra la herramienta. Es contra el contenido intercambiable.
Un modelo puede ayudarnos a ordenar una entrevista, detectar inconsistencias en un borrador, clasificar cientos de respuestas, explorar ángulos posibles o transformar datos complejos en una primera explicación. Todo eso puede mejorar el proceso editorial.
El riesgo aparece cuando también le delegamos la fuente del conocimiento. Si la única información que utilizamos para crear un artículo es aquello que el modelo ya aprendió o recuperó de otros, es difícil esperar que el resultado aporte algo que haga necesaria nuestra página.
La IA puede ayudarnos a expresar conocimiento. La ventaja editorial aparece cuando ese conocimiento tiene un origen que va más allá de la propia IA.
Lee también: AI Overviews: cómo optimizar tu SEO para IA
Lo que una marca puede aportar y una IA no puede obtener sin una fuente
Imaginemos que preguntamos a un LLM cuáles son los principales problemas que enfrentan las empresas latinoamericanas al implementar AEO. El modelo puede sintetizar documentación existente, comparar opiniones y construir una respuesta razonable.
Ahora imaginemos otra situación. Una empresa analiza durante seis meses 10.000 respuestas generativas para prompts comerciales en Colombia, México, Argentina y Chile. Documenta qué dominios son citados, qué marcas aparecen sin enlace, cómo cambia el comportamiento entre países y qué patrones se repiten por industria.
Un modelo podría resumir ese estudio una vez publicado. Pero alguien tendría que producir primero los datos.
Esa es la diferencia entre generar contenido y generar conocimiento.
Los datos propios son una forma evidente de hacerlo, pero no la única. La experiencia acumulada también contiene información que puede documentarse. Un equipo que ha realizado cien migraciones SEO probablemente haya observado problemas que todavía no aparecen bien explicados en un manual. Un área comercial que escucha cientos de conversaciones al mes puede reconocer objeciones antes de que alguien publique una encuesta sobre ellas. Un equipo de producto conoce decisiones, experimentos fallidos y comportamientos de usuarios que un agregador externo no puede observar directamente.
Los casos reales son especialmente útiles cuando no se reducen a la típica historia de éxito. Saber que una estrategia aumentó una métrica puede ser interesante; saber en qué condiciones funcionó, qué se midió, qué limitaciones aparecieron y cuándo no volveríamos a utilizarla produce conocimiento mucho más transferible.
Lo mismo ocurre con la perspectiva experta. Tener una perspectiva no consiste en añadir una opinión provocadora a un artículo. Consiste en interpretar evidencia y experiencia para ayudar a alguien a tomar una decisión que los datos, por sí solos, no resuelven.
Latinoamérica tiene además un vacío que puede convertirse en oportunidad
Buena parte de la investigación reciente sobre AI Search utiliza datasets internacionales o predominantemente anglófonos. La evidencia que revisamos no permite asumir que todos esos patrones se reproducen de manera idéntica en Colombia, México, Chile, Perú, Argentina o el resto de la región.
Eso representa una limitación para este mismo artículo, y conviene reconocerla. Pero también señala una oportunidad editorial: si todavía sabemos poco sobre cómo se comportan ciertas consultas, industrias o audiencias latinoamericanas frente a AI Search, las empresas que produzcan esa evidencia pueden convertirse en las fuentes que hoy faltan.
Haz humana la información y fácil de recuperar su evidencia
Tener información original tampoco garantiza que alguien vaya a encontrarla. Una investigación excelente puede quedar enterrada dentro de una página confusa, igual que una respuesta útil puede perderse bajo una introducción de quinientas palabras.
Por eso la estructura sigue importando, aunque no haga falta inventar una plantilla especial para LLM.
Si un encabezado pregunta “¿Qué hace que un contenido sea citable por IA?”, la respuesta debería aparecer al comienzo de esa sección y desarrollarse después con contexto y evidencia. Los encabezados deberían describir lo que realmente contienen; una comparación puede beneficiarse de una tabla; un proceso, de una secuencia; una definición, de una formulación clara antes de entrar en matices.
No se trata de escribir cada idea en una línea ni de forzar párrafos de una longitud determinada. Estructurar para AI Search debería significar reducir la ambigüedad, no convertir la prosa en bloques artificiales.
También implica tratar mejor las fuentes. Si un artículo menciona que “un estudio encontró X”, vale la pena buscar ese estudio. Si una presentación muestra una estadística llamativa, conviene revisar si conocemos su muestra y metodología. Y si cinco blogs repiten exactamente el mismo porcentaje pero todos terminan apuntando a una única fuente que no podemos verificar, no tenemos cinco evidencias: tenemos una afirmación repetida cinco veces.
Eso fue precisamente lo que intentamos hacer con las diapositivas que dieron origen a este artículo. Como no conseguimos verificar suficientemente algunos de sus datos, preferimos explicar la limitación antes que utilizarlos para construir una conclusión más atractiva.
Paradójicamente, esa decisión también forma parte de escribir contenido para IA.
Una fuente útil no solo ofrece respuestas; permite rastrear de dónde salieron.
De contenido genérico a contenido que merece convertirse en fuente
Veamos la diferencia con un ejemplo.
Una versión genérica podría decir:
“El AEO es cada vez más importante para las empresas porque los consumidores utilizan inteligencia artificial para buscar información. Las marcas deben adaptar su estrategia para mantenerse competitivas.”
La afirmación podría ser razonable, pero es intercambiable. No sabemos de dónde sale, qué significa exactamente “adaptarse” ni qué decisión debería tomar alguien después de leerla.
Un experto podría avanzar un poco más:
“Las empresas no deberían tratar AEO como un reemplazo del SEO. La indexación, la relevancia, la autoridad y la arquitectura del contenido siguen condicionando qué información puede recuperar un motor generativo.”
Aquí ya hay una posición. Para convertirla en una afirmación más útil como fuente, podemos hacer explícito su sustento:
“Google señala en su documentación de 2026 que las prácticas fundamentales de SEO continúan siendo relevantes para AI Overviews y AI Mode porque estas experiencias se apoyan en sus sistemas centrales de Search. Por eso, en Triario tratamos AEO como una capa adicional de distribución y medición, no como un sustituto de la indexabilidad, relevancia y autoridad que ya exige el SEO.”
La diferencia no consiste en hacer el tercer párrafo más largo. Consiste en que ahora podemos distinguir el hecho documentado por Google de la interpretación estratégica que hace Triario a partir de él.
Esa separación aumenta la utilidad de la información y también hace que nuestra perspectiva sea identificable.
Siete preguntas para crear contenido que merezca ser citado
No podemos garantizar que una página vaya a ser citada por ChatGPT, Gemini, Perplexity o Google. Sí podemos elevar considerablemente el estándar de aquello que publicamos. Para hacerlo, proponemos revisar cada pieza con siete preguntas.
1. ¿Qué sabemos nosotros que los demás no saben?
Antes de abrir el documento, conviene preguntarse de dónde va a salir el conocimiento que queremos publicar. Puede estar en los datos de la empresa, en conversaciones con clientes, en experimentos, en la experiencia de los expertos internos, en procesos que el equipo ha desarrollado o incluso en errores que ha cometido y documentado. También puede estar en observaciones que todavía nadie se ha tomado el trabajo de convertir en información útil.
Si la única materia prima son los diez primeros resultados de Google, hay una buena probabilidad de que terminemos publicando, con otras palabras, el resultado número once.
2. ¿Podemos convertir esa experiencia en evidencia?
Decir “vemos esto todo el tiempo” transmite experiencia, pero sigue siendo una afirmación difícil de evaluar. Si podemos documentar cuántos casos observamos, durante qué periodo, en qué contexto y qué ocurrió, la experiencia empieza a convertirse en evidencia.
No todo contenido empresarial necesita convertirse en un paper académico. Sí debería permitir entender por qué confiamos en una conclusión.
3. ¿Qué está respondiendo realmente cada sección?
Un H2 no debería existir simplemente porque necesitamos introducir otra variación de keyword. Si no podemos explicar en una frase qué aprende el lector en una sección, probablemente debamos replantearla.
La estructura SEO funciona mejor cuando refleja la estructura real del conocimiento.
4. ¿Qué afirmaciones necesitan una fuente?
No hace falta añadir una referencia después de cada oración. Las estadísticas, cambios recientes en plataformas, afirmaciones técnicas, conclusiones de investigaciones y declaraciones discutibles sí deberían tener un respaldo identificable.
Siempre que sea posible, es preferible enlazar la fuente primaria antes que el artículo que la resumió.
5. ¿La presentación facilita entender y recuperar la información?
Aquí entran los encabezados descriptivos, las tablas cuando existe una comparación real, las listas cuando hay una secuencia y los párrafos suficientemente enfocados como para que quede claro qué idea desarrollan.
El objetivo no es fragmentar la prosa hasta hacerla robótica. Es evitar que la información importante dependa de que el lector adivine cómo está organizada.
6. ¿Explicamos cuándo nuestra conclusión deja de aplicar?
Una recomendación es más útil cuando conocemos sus límites. Si un hallazgo proviene de búsquedas en inglés, hay que decirlo. Si un estudio es correlacional, no deberíamos convertirlo en causal. Si una estrategia funcionó únicamente para e-commerce, tampoco deberíamos presentarla como una ley del B2B.
El contexto no debilita una afirmación bien sustentada; ayuda a saber cuándo utilizarla.
7. ¿Cuándo tendremos que revisar esta pieza?
Esta pregunta es especialmente importante en AI Search. Una investigación de 2024 puede seguir siendo relevante para entender el origen de GEO y, al mismo tiempo, resultar demasiado antigua para describir cómo funciona Google AI Mode en septiembre de 2026.
La fecha de la evidencia también forma parte de la evidencia.
SEO, AEO y GEO: ¿qué cambia realmente?
La aparición de AI Search vino acompañada de un nuevo vocabulario. SEO convive ahora con AEO, GEO, LLMO y AI Search Optimization. Las etiquetas pueden ayudar a describir cambios reales, pero también pueden hacernos creer que todo empezó de cero.
No fue así.
Para Google, la posición oficial sigue siendo que las prácticas fundamentales de SEO son relevantes para AI Overviews y AI Mode. Una página que no puede rastrearse, indexarse o interpretarse correctamente ya tiene un problema antes de que empecemos a discutir cómo conseguir una cita generativa.
Lo que sí cambia es el espacio en el que buscamos visibilidad y, por tanto, parte de lo que necesitamos medir. Además de posiciones y clics, ahora interesa saber si una marca aparece dentro de una respuesta, si su dominio es citado, para qué conjuntos de preguntas sucede, qué información recupera el sistema y cómo cambia esa presencia entre plataformas.
Esto tampoco significa que cada táctica etiquetada como GEO sea genuinamente nueva. Muchas recomendaciones actuales —arquitectura clara, contenido útil, autoridad temática, fuentes verificables, buena accesibilidad técnica— son principios conocidos del SEO y de la estrategia de contenidos. La novedad está más claramente en fenómenos como query fan-out, selección y absorción de citas, fragmentación entre motores, volatilidad de respuestas y la necesidad de medir menciones y citaciones además del ranking tradicional.
Lee también: AEO vs. SEO: guía avanzada sobre la evolución del posicionamiento 2026
Qué sabemos y qué todavía no sabemos sobre contenido citable
Hay otra práctica que creemos útil en un tema tan reciente: separar aquello que la evidencia permite sostener razonablemente de aquello que todavía estamos intentando entender.
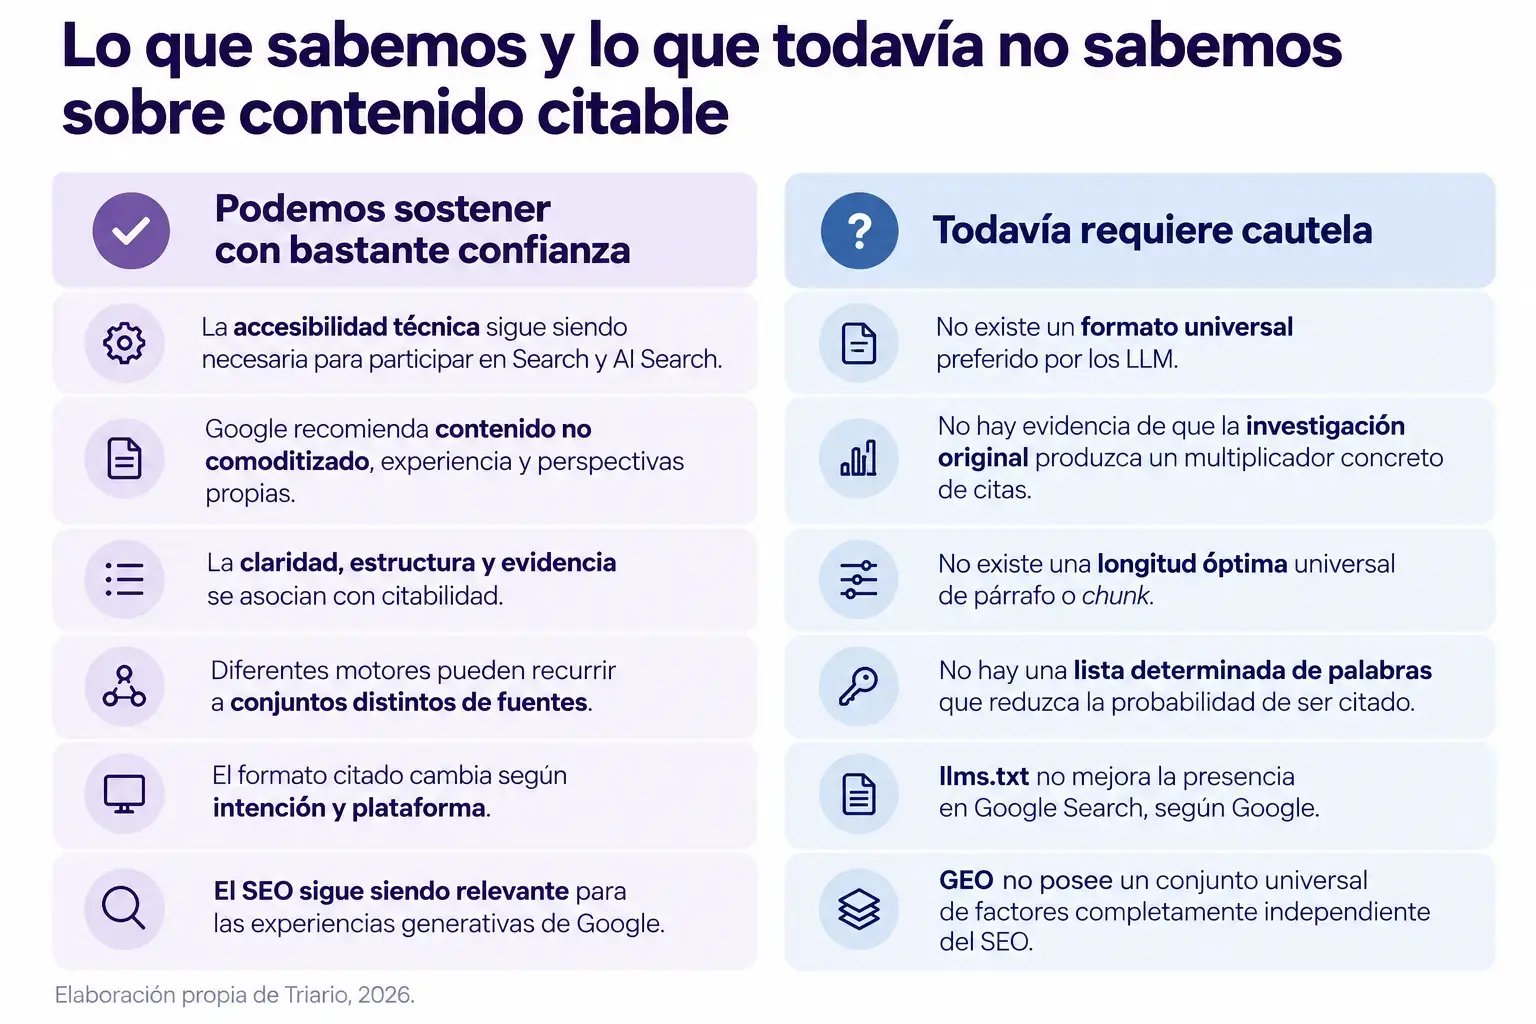 La columna de la derecha no es una lista de mitos demostrados. Algunas de esas hipótesis podrían acumular evidencia con el tiempo. Lo importante es no adelantarnos a ella.
En una industria que cambia cada pocos meses, reconocer la diferencia entre “sabemos”, “observamos” y “suponemos” puede ser más valioso que publicar otra certeza prematura.
El futuro del contenido no es escribir más: es tener más que decir
La IA redujo muchísimo el costo de una parte del trabajo editorial. Podemos producir borradores más rápido, resumir información, explorar enfoques, reorganizar argumentos y automatizar tareas que antes consumían horas.
Eso debería permitirnos invertir más tiempo en la parte que sigue siendo difícil: encontrar algo que valga la pena publicar.
Investigar una pregunta de verdad, acumular experiencia, obtener datos propios, entrevistar a alguien que sabe más que nosotros, documentar un proceso, estudiar un fracaso o comprobar si una estadística espectacular tiene una metodología detrás siguen requiriendo trabajo. Y precisamente por eso pueden convertirse en una ventaja.
Quizá la pregunta más útil para un equipo de marketing en 2026 ya no sea cuánto contenido puede producir con IA, sino qué puede hacer ahora con el tiempo que la IA le devolvió.
Si la respuesta es producir cinco veces más versiones de aquello que todos los demás ya publicaron, internet tendrá más palabras.
Si usamos ese tiempo para investigar, experimentar y documentar mejor lo que sabemos, tendremos más conocimiento.
Y entonces la optimización adquiere otro sentido. No se trata de sonar menos como una IA para engañar a una IA. Se trata de producir información que merezca convertirse en fuente y presentarla de una manera que permita encontrarla, entenderla y verificarla.
Dale a la IA una razón para necesitar tu fuente.
Haz que tu marca se convierta en fuente
Tu empresa probablemente ya produce conocimiento sin llamarlo así. Está en las conversaciones con clientes, en los datos que analiza, en los experimentos que ejecuta, en las decisiones de sus especialistas y en todo aquello que aprendió haciendo el trabajo.
El reto editorial consiste en identificar ese conocimiento y convertirlo en activos que puedan ser encontrados, comprendidos y citados.
En Triario integramos SEO y AEO para ayudar a las marcas a construir esa visibilidad tanto en buscadores como en motores de respuesta.
Preguntas frecuentes sobre contenido para IA
¿Qué hace que un contenido sea citado por ChatGPT o Google AI Overviews?
No conocemos un factor único que garantice una cita. La evidencia disponible apunta a una combinación de accesibilidad técnica, relevancia para la consulta, claridad y disponibilidad de información o evidencia útil para construir la respuesta. Además, los diferentes motores pueden seleccionar conjuntos distintos de fuentes, por lo que una buena visibilidad en uno no garantiza el mismo resultado en otro.
¿Los listicles tienen más posibilidades de ser citados por la IA?
Los listicles aparecen con frecuencia en algunos estudios recientes, especialmente en determinadas consultas comerciales, pero esto no demuestra que convertir un artículo en lista provoque más citas. Los datasets revisados muestran que el tipo de contenido citado cambia según la intención de búsqueda y la plataforma.
¿El contenido generado por IA puede aparecer en AI Overviews?
Google no establece que un contenido deba estar escrito exclusivamente por humanos para participar en Search. Su orientación se centra en la utilidad y el valor para las personas. Utilizar IA durante el proceso de producción no equivale, por sí solo, a producir contenido de baja calidad; el problema aparece cuando la automatización se utiliza para generar contenido sin valor añadido o principalmente para manipular rankings.
¿Hay palabras que hacen que un texto parezca escrito por IA?
La investigación lingüística ha identificado términos y patrones sobrerrepresentados en textos generados por determinados modelos, pero eso no equivale a una lista universal de “palabras de IA”. Tampoco encontramos evidencia suficiente para afirmar que usar un término específico reduzca por sí mismo las probabilidades de que un motor generativo cite una página.
¿Cuál es la diferencia entre SEO, AEO y GEO?
SEO busca mejorar la visibilidad y el rendimiento en motores de búsqueda. AEO pone más énfasis en que la información pueda resolver preguntas y participar en respuestas directas, mientras que GEO suele utilizarse para describir la optimización de presencia, menciones y citaciones en experiencias generativas. En la práctica existe un solapamiento considerable: accesibilidad, relevancia, autoridad y buen contenido siguen siendo fundamentos comunes.
¿Cómo saber si mi contenido está siendo citado por motores de IA?
Conviene medir conjuntos de prompts relevantes para el negocio y hacerlo por plataforma, distinguiendo entre mención de marca, aparición del dominio como fuente, utilización de la información dentro de la respuesta, tráfico referido y conversión. Debido a la variabilidad de estos sistemas, ejecutar una única consulta y comprobar si la marca aparece ofrece una fotografía demasiado limitada.
Cómo investigamos este artículo
Este artículo surgió a partir de dos diapositivas vistas por el equipo de Triario en INBOUND 2026, en Boston. A partir de ellas contrastamos documentación oficial, investigación académica y estudios industriales publicados principalmente entre 2025 y septiembre de 2026.
Priorizamos fuentes primarias y trabajos con una metodología y una muestra identificables. Cuando un estudio muestra una correlación, intentamos no convertirla en causalidad; cuando una conclusión es una interpretación de Triario, la presentamos como tal. También evitamos trasladar automáticamente resultados obtenidos en inglés o en mercados internacionales al contexto latinoamericano.
Al cierre de nuestra investigación no encontramos documentación metodológica pública suficiente para verificar de forma independiente las cifras específicas atribuidas a Worldata Research 2026 Performance Aggregate. Por esa razón, las diapositivas funcionan en este artículo como el origen de la pregunta, no como evidencia para responderla.
Última revisión: septiembre de 2026.
